Agent Harness: vì sao cùng một model ra 62,7% và 99,9%
Cùng một model. Cùng một bài kiểm tra. Một bên ra 62,7%, bên kia ra 99,9%. Hai con số này không phải gõ nhầm, đây là kết quả công bố chính thức của ARC Prize cho GPT-6 Astra trên ARC-AGI-3. Thứ khác nhau giữa hai lần đo đó gọi là Agent Harness, hay tôi gọi cho dễ là bộ khung chạy quanh cái model.
Video gốc tôi chia sẻ ngày 13/09/2026. Bài viết này giữ nguyên mạch của video, thêm vào ba thứ video không có: bảng số liệu đầy đủ đọc từ đúng khung hình, định nghĩa gốc của hai bộ khung lấy từ ARC Prize, và một mục Giới hạn thật nói rõ chỗ nào con số dễ bị trích sai.
Anh em sẽ đi qua tám ý sau:
- Hai con số 62,7% và 99,9% thật ra đo cái gì
- Model mới có mạnh hơn thật không
- ARC-AGI-3 khó ở chỗ nào
- Agent Harness là gì, nói bằng chuyện căn bếp
- Vì sao đổi bộ khung lại kéo điểm từ 17,5% lên 98%
- Chuyện tiền, chỗ ngược đời nhất trong bảng
- Ba lớp phải nhìn: Model, Bộ khung, Kiểm soát
- Giới hạn thật của mấy con số này
Hai con số 62,7% và 99,9% thật ra đo cái gì?
Cả hai đều là GPT-6 Astra chạy trên ARC-AGI-3 Semi-Private, khác nhau đúng một thứ là bộ khung bao quanh model. Bộ khung tiêu chuẩn của ARC Prize cho ra 62,7%. Bộ khung do chính nhà cung cấp dựng cho ra 99,9%.
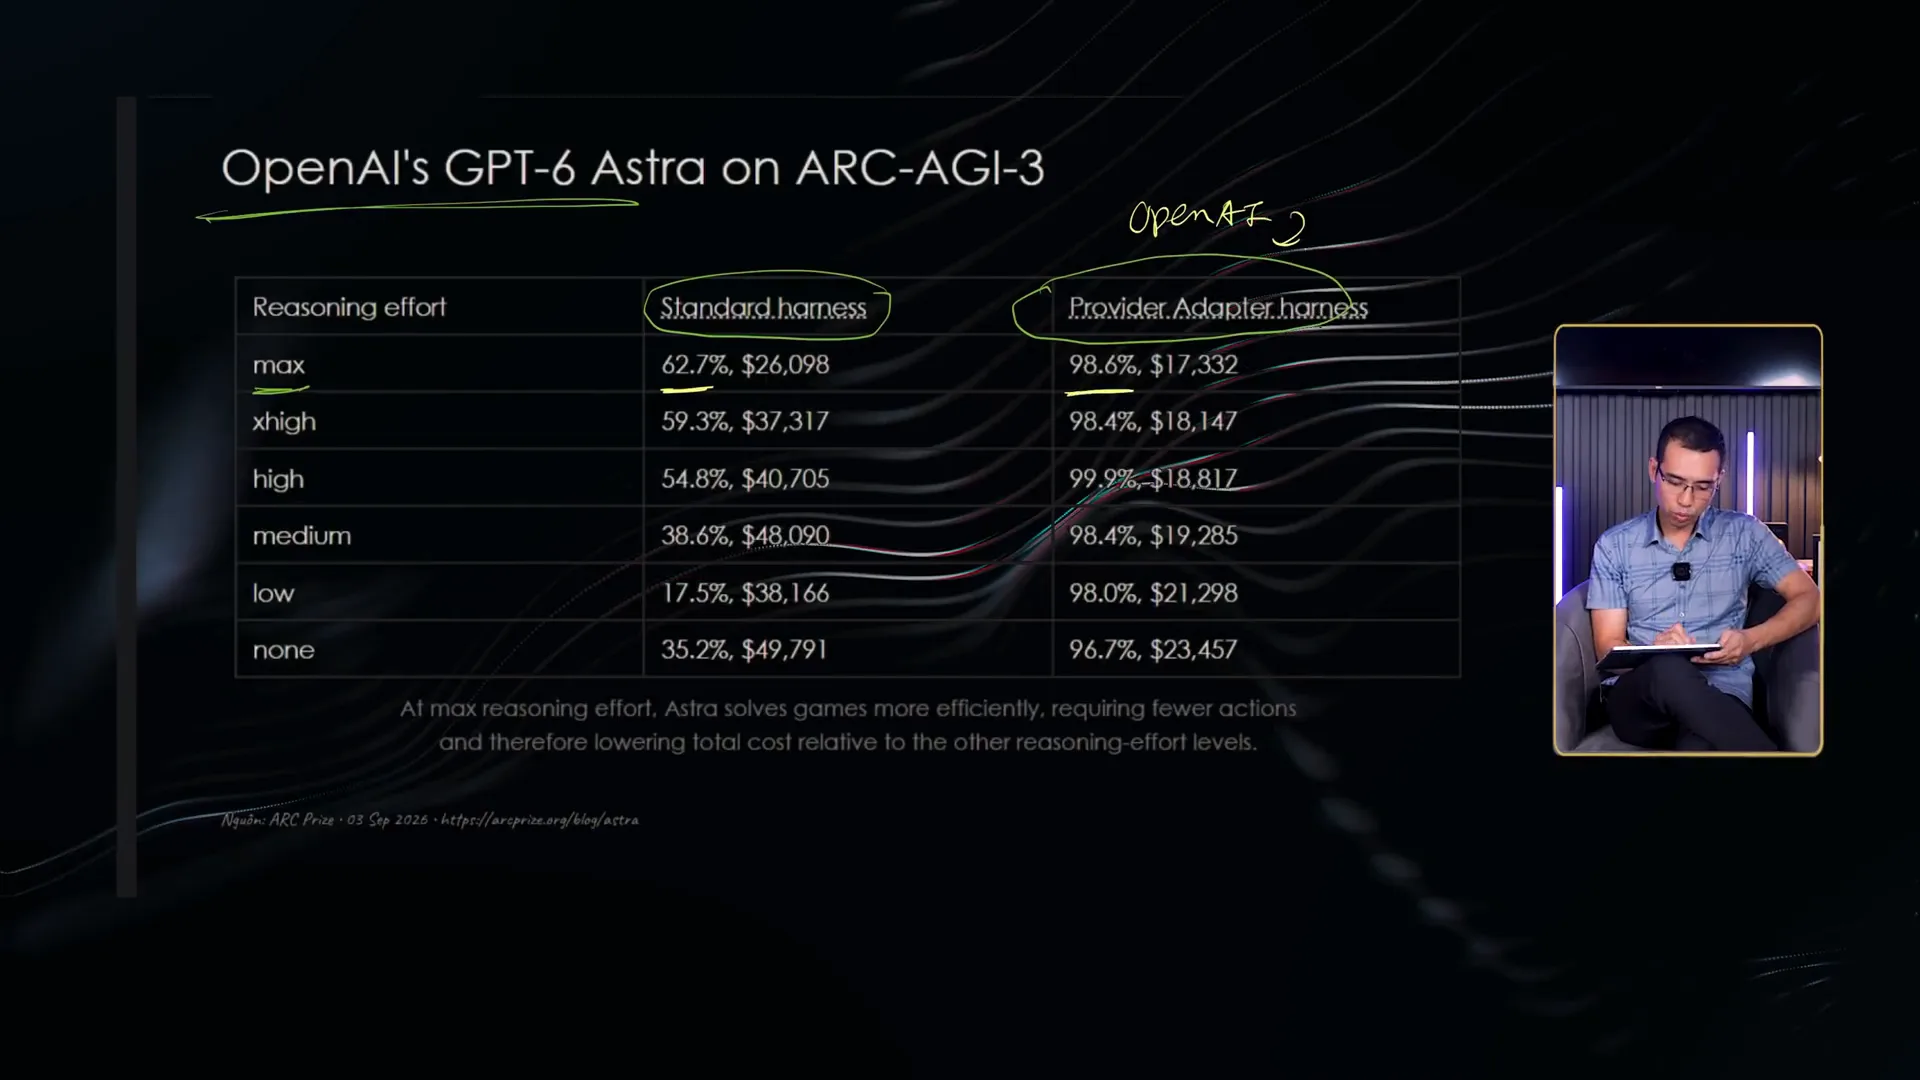
Đây là bảng đầy đủ, tôi chép lại đúng như ARC Prize công bố:
| Mức reasoning | Standard harness | Provider Adapter harness |
|---|---|---|
| max | 62,7% · 26.098 USD | 98,6% · 17.332 USD |
| xhigh | 59,3% · 37.317 USD | 98,4% · 18.147 USD |
| high | 54,8% · 40.705 USD | 99,9% · 18.817 USD |
| medium | 38,6% · 48.090 USD | 98,4% · 19.285 USD |
| low | 17,5% · 38.166 USD | 98,0% · 21.298 USD |
| none | 35,2% · 49.791 USD | 96,7% · 23.457 USD |
Anh em nhìn kỹ một chút. Con số 99,9% nằm ở dòng high, không nằm ở dòng max. Còn 62,7% nằm ở dòng max. Tức là hai con số nổi tiếng nhất của lần công bố này thậm chí không cùng một mức reasoning. Chỗ này rất dễ trích sai, tôi để riêng một mục Giới hạn thật ở dưới để nói cho hết.
Nhưng kể cả so ở cùng một mức thì khoảng cách vẫn khủng khiếp. Ở mức max, 62,7% so với 98,6%. Ở mức low, 17,5% so với 98,0%. Một bên thi trượt, một bên gần như làm xong sạch.
Model mới có mạnh hơn thật không?
Có, và chỗ này phải công tâm. Trước khi phản biện bất kỳ con số nào tôi vẫn phải nói rằng GPT-6 Astra có cải tiến thật, đây là công bố của chính OpenAI.
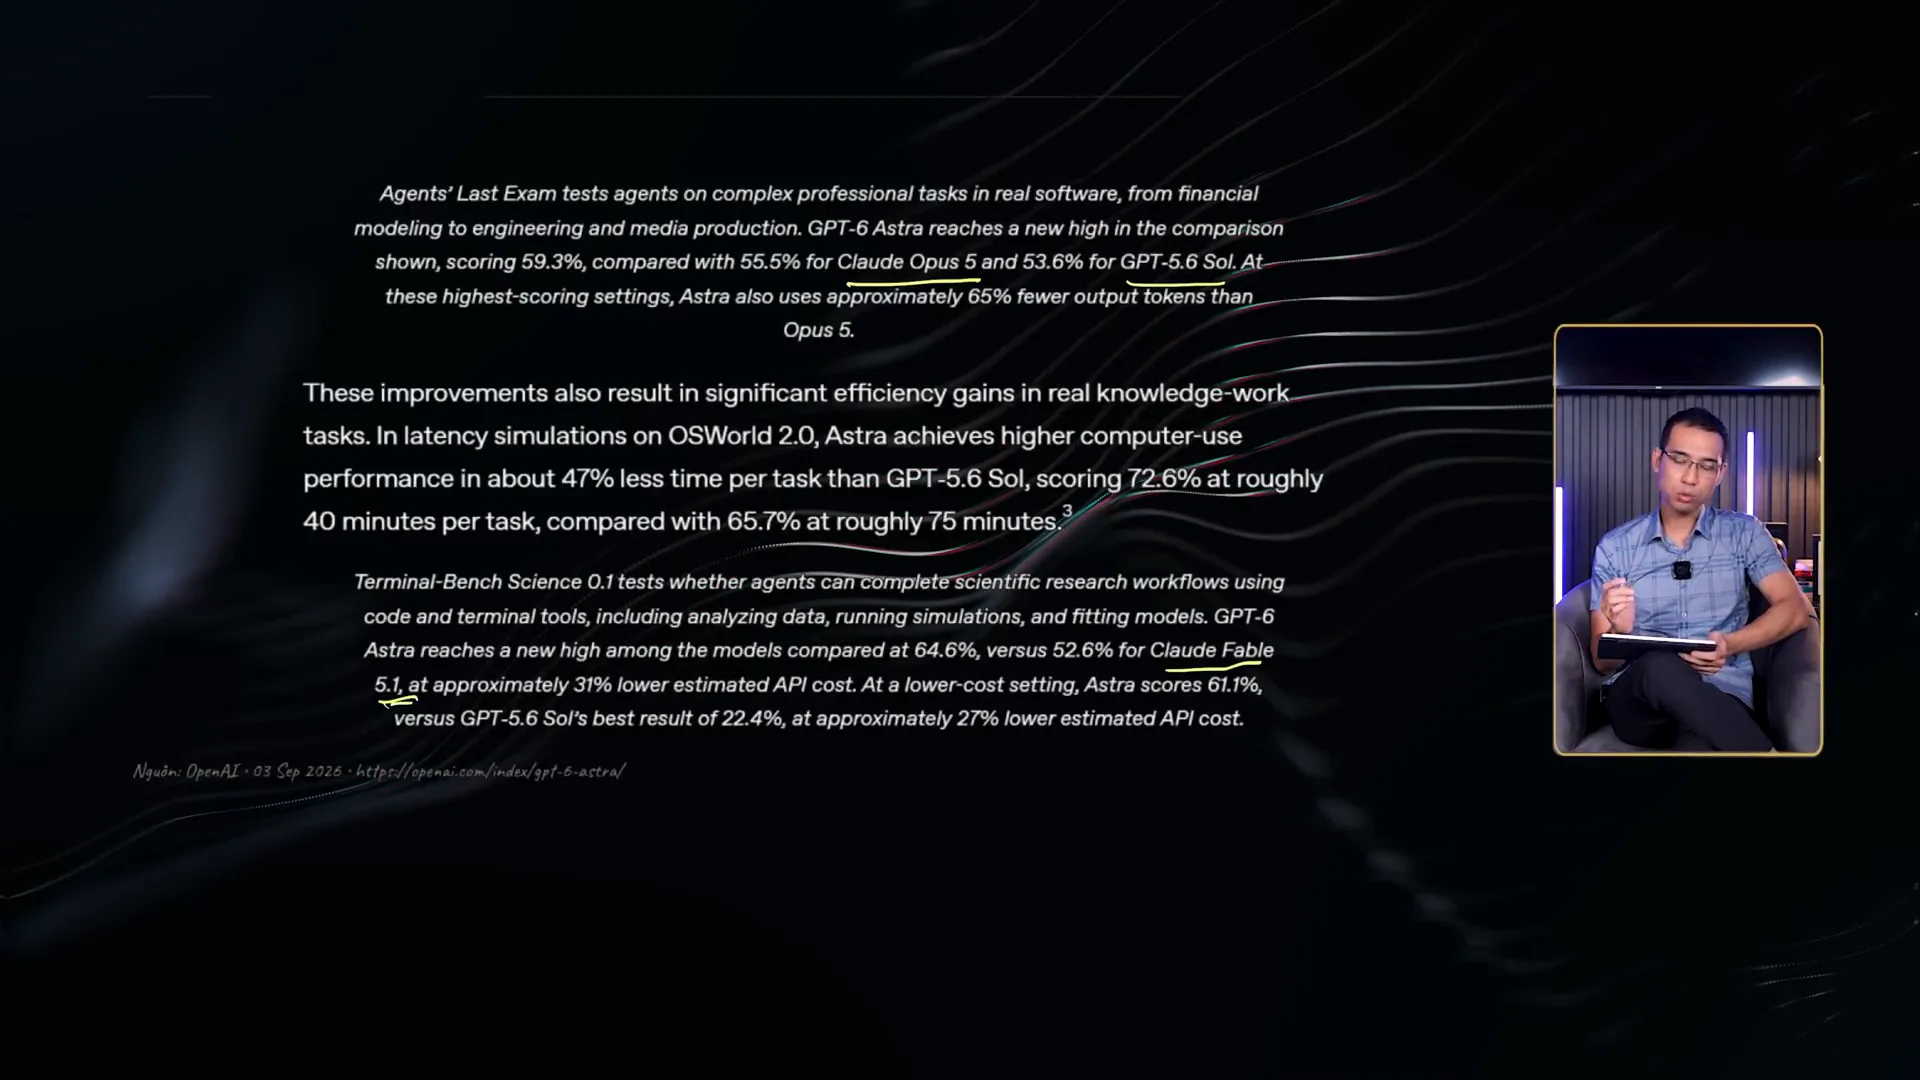
Ba con số đáng nhớ trong đó:
- Agents' Last Exam, Astra được 59,3%, Claude Opus 5 được 55,5%, GPT-5.6 Sol được 53,6%. Ở cấu hình điểm cao nhất đó, Astra dùng ít hơn khoảng 65% token đầu ra so với Opus 5.
- OSWorld 2.0, Astra được 72,6% với khoảng 40 phút mỗi đầu việc, GPT-5.6 Sol được 65,7% với khoảng 75 phút. Nhanh hơn chừng 47%.
- Terminal-Bench Science 0.1, Astra được 64,6%, Claude Fable 5.1 được 52,6%, và chi phí API ước tính thấp hơn khoảng 31%.
Đấy. Model có tiến bộ, tôi không cãi. Nhưng tiến bộ của model không tự động biến thành một hệ thống Agent chạy được trong doanh nghiệp. Đó mới là thứ tôi muốn anh em nhìn ra.
ARC-AGI-3 khó ở chỗ nào mà model mạnh vẫn trượt?
Nó khó vì không ai nói cho anh luật chơi. ARC-AGI-3 ném agent vào một môi trường lạ hoắc, không mô tả mục tiêu, không mô tả cách thắng, rồi bảo anh tự mò ra.
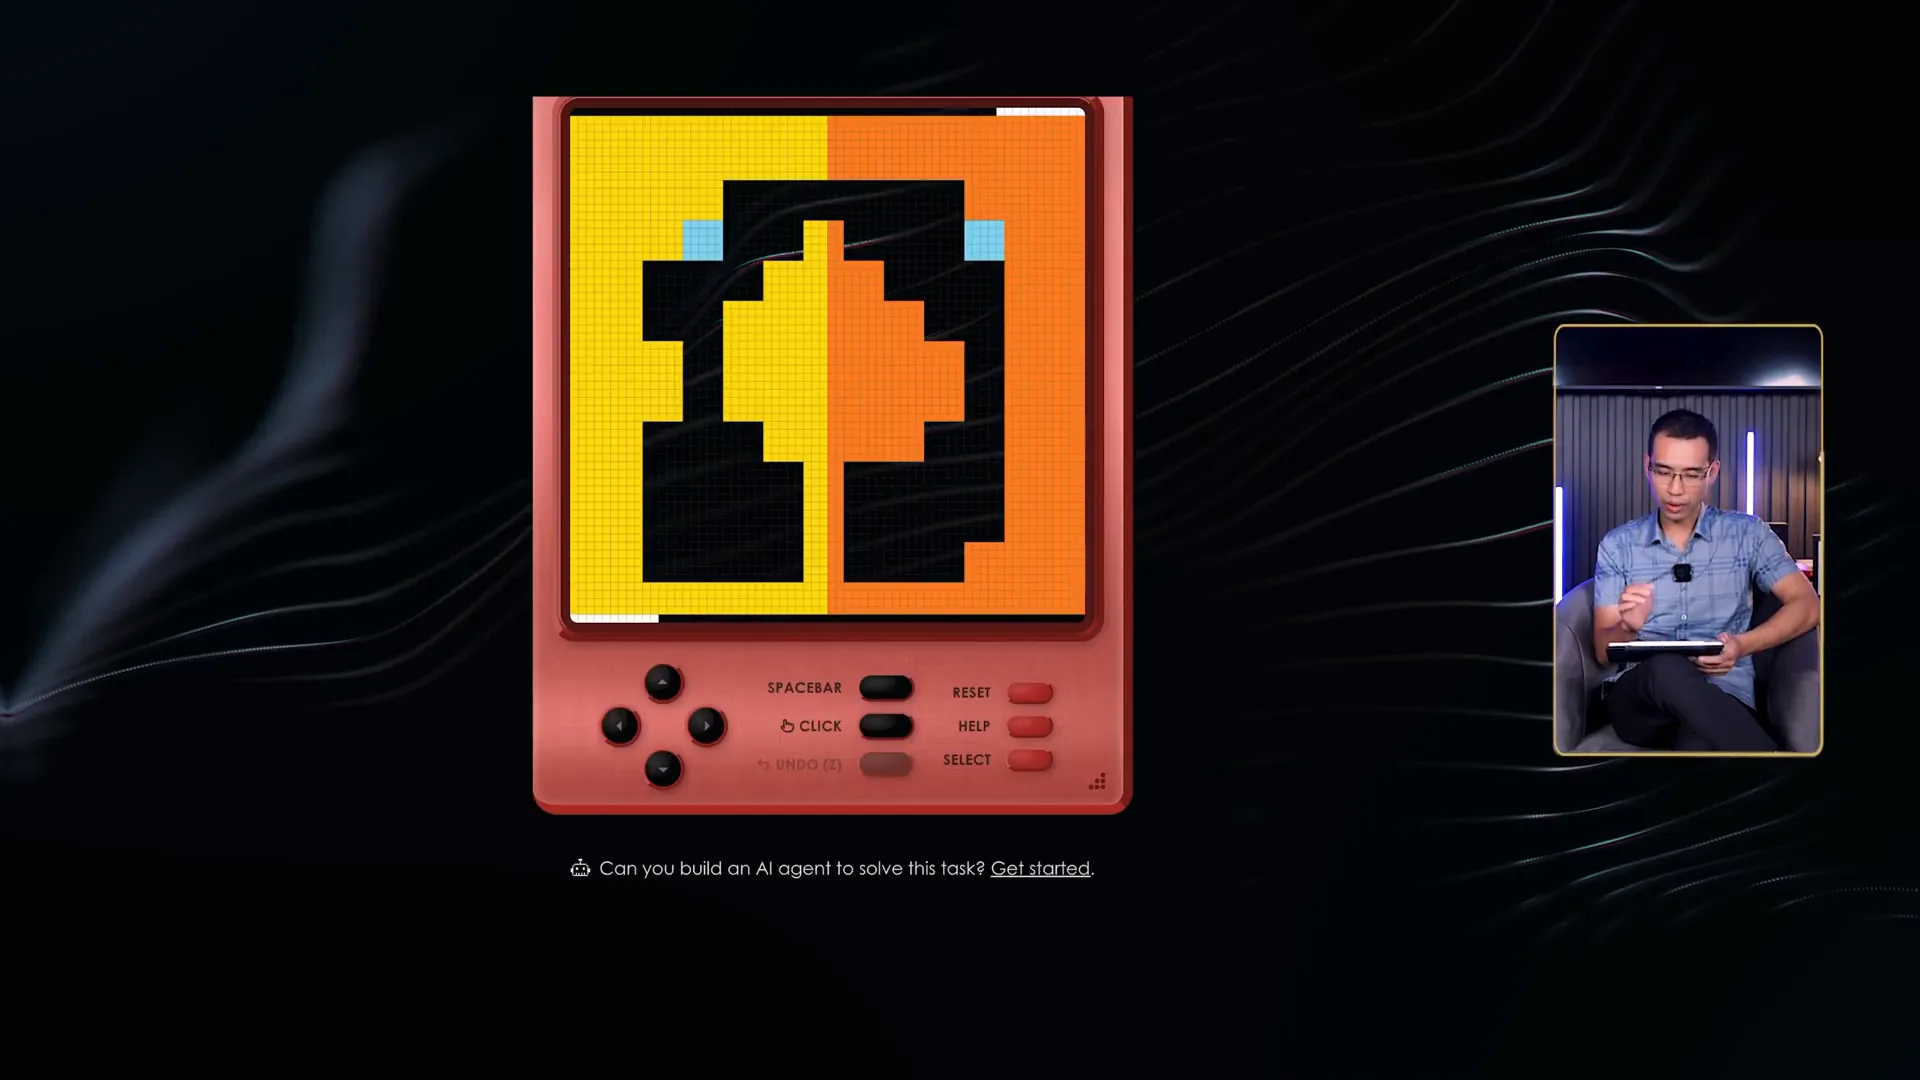
Tôi bấm thử lên, bấm thử xuống. Hai ông cùng chạy ra. Rồi sao nữa? Chưa biết. Bấm tiếp. Vẫn chưa biết. Toàn bộ luật chơi phải tự đoán, và trong lúc đoán thì phải nhớ được mình đã thử gì rồi, cái nào có tác dụng, cái nào không.
ARC Prize nói rõ họ đo bốn thứ:
| Thành phần | Đo cái gì |
|---|---|
| Exploration | Tự đi lấy thông tin, vì không ai đưa sẵn |
| Modeling | Biến thứ quan sát được thành một mô hình đoán được tương lai |
| Goal-setting | Tự xác định đích đến khi phần thưởng rất thưa |
| Planning và execution | Vạch đường tới đích, gặp thông tin mới thì bẻ lái |
Anh em thấy quen không? Đây chính là môi trường công việc thật. Đề bài mơ hồ, biến số mở, không ai cầm tay chỉ việc, và làm sai thì phải nhớ để lần sau đừng sai nữa. ARC Prize còn cho biết con người giải được 100% số môi trường này.
Agent Harness là gì, nói cho dễ hiểu?
Bản chất nó là toàn bộ thứ chạy quanh cái model, chứ model chỉ là bộ não. Anh em hình dung một nhà hàng.
Ông đầu bếp chính là model. Ông biết công thức, biết khách yêu cầu gì thì nấu ra sao, suy luận ngon lành. Nhưng ông đầu bếp giỏi mà tôi vứt vào một căn bếp lạ thì sao? Ông không biết nồi để đâu, dao để đâu. Nguyên liệu hôm nay nhập của ai ông cũng không biết. Ông đã làm tới bước nào ông cũng quên.
Cái căn bếp đó là bộ khung. Trong căn bếp còn một thứ nữa, đó là quyển sổ ghi chú. Sổ ghi nguyên liệu nhập từ đâu, món này trước đây làm mất bao lâu, lần trước hỏng ở chỗ nào.
Ba thứ phải đi cùng nhau mới ra được đĩa thức ăn. Đầu bếp giỏi, căn bếp đủ đồ, quyển sổ ghi đủ việc. Thiếu căn bếp thì ông đầu bếp giỏi mấy cũng đứng chịu trận.
Quay lại cái game lúc nãy. Thằng model không phải chỉ suy luận. Nó phải lưu được trạng thái, phải nhớ nước đi trước đó ra kết quả gì, thì nó mới biết nước tiếp theo nên đi đâu. Việc nhớ đó không nằm trong model. Nó nằm trong bộ khung.
Và đây là định nghĩa gốc của hai bộ khung, lấy đúng từ ARC Prize. Chỗ này video tôi nói gọn, bài viết nói đủ:
| Standard harness | Provider Adapter harness | |
|---|---|---|
| Ai dựng | ARC Prize dựng, dùng chung cho mọi model | Chính nhà cung cấp model dựng |
| Cách giữ trạng thái | Model tự chọn ghi chú nào đáng mang theo, rồi tự mang | Giữ nguyên trạng thái suy luận dạng đóng giữa các lượt gọi |
| Khi ngữ cảnh đầy | Model tự xoay xở | Tự nén ngữ cảnh lại, cho phép model dùng lại phần đã nghĩ |
| Điểm cao nhất đo được | 62,7% ở mức max | 99,9% ở mức high |
Nhìn dòng thứ hai và thứ ba là ra vấn đề. Bộ khung tiêu chuẩn bắt model tự gánh việc ghi nhớ. Bộ khung của hãng gánh hộ, và còn nén ngữ cảnh khi hội thoại dài ra.
Vì sao đổi bộ khung lại kéo điểm từ 17,5% lên 98%?
Vì bốn thứ bộ khung làm hộ đều là thứ model không tự làm được. Tôi liệt kê ra cho cụ thể.
Thứ nhất là trạng thái. Nó đang làm tới bước nào, bước đó ra kết quả gì. Không có chỗ cất thì chạy một lúc là quên sạch. Tôi có phân tích kỹ chuyện quên này trong bài bộ nhớ của AI Agent và vì sao AI hay quên.
Thứ hai là ngữ cảnh. Làm việc càng lâu, ngữ cảnh càng phình. Đầy thì phải nén, phải quyết định giữ gì bỏ gì. Đây cũng chính là chỗ đốt tiền nhiều nhất, tôi có chia sẻ trong bài token là gì và vì sao chat AI càng dài càng tốn tiền.
Thứ ba là gọi công cụ. Trong việc thật thì nó phải gọi rất nhiều thứ, đọc file, phân tích dữ liệu, vào web lấy số. Gọi đúng công cụ đã khó, truyền đúng tham số còn khó hơn.
Thứ tư là chỗ dừng lại hỏi. Bước nào quan trọng thì phải xin xác nhận, không được tự tiện làm. Chuyện này tôi có chia sẻ riêng trong bài AI Agent làm sai vì thiếu tiêu chí đạt và người duyệt.
Và đây là bằng chứng rõ nhất, thứ không nằm trong bảng tổng. ARC Prize công bố điểm từng game một trong bộ 25 môi trường. Với bộ khung tiêu chuẩn, có game Astra được 0,0%, có game được 2,2%, có game được 3,1%. Với bộ khung của hãng, gần như cả 25 game đều 100%.
Nghĩa là khoảng cách giữa hai bộ khung không rải đều. Nó dồn vào đúng những game đòi khám phá dài và nhớ nhiều. Model vẫn là model đó. Chỉ là khi phải tự gánh việc nhớ thì nó gục ở đúng chỗ khó nhất.
Chuyện tiền, chỗ ngược đời nhất trong bảng
Cho model suy luận nhiều hơn lại tốn ít tiền hơn. Nghe ngược nhưng số liệu nó thế.
Anh em nhìn lại cột Standard harness. Mức max hết 26.098 USD. Mức medium hết 48.090 USD, tức gần gấp đôi. Mức none hết 49.791 USD, còn đắt hơn nữa.
Vì sao? Vì khi nó suy luận tốt, nó giải xong bài trong ít nước đi hơn. Ít nước đi thì ít lượt gọi model, ít token, tổng tiền xuống. Còn suy luận kém thì nó mò, mà mò thì mỗi lượt rẻ nhưng số lượt phình lên khủng khiếp.
Đây là bài học tôi muốn anh em mang về ngay: đừng mặc định hạ mức suy luận xuống là tiết kiệm. Có khi hạ xuống lại đắt gấp đôi. Phải đo trên chính công việc của mình. Tôi có chia sẻ cách cắt tiền token theo hướng chia nhỏ việc trong bài multi-agent trên OpenClaw để chia việc và giảm tiền token.
Ba lớp phải nhìn: Model, Bộ khung, Kiểm soát
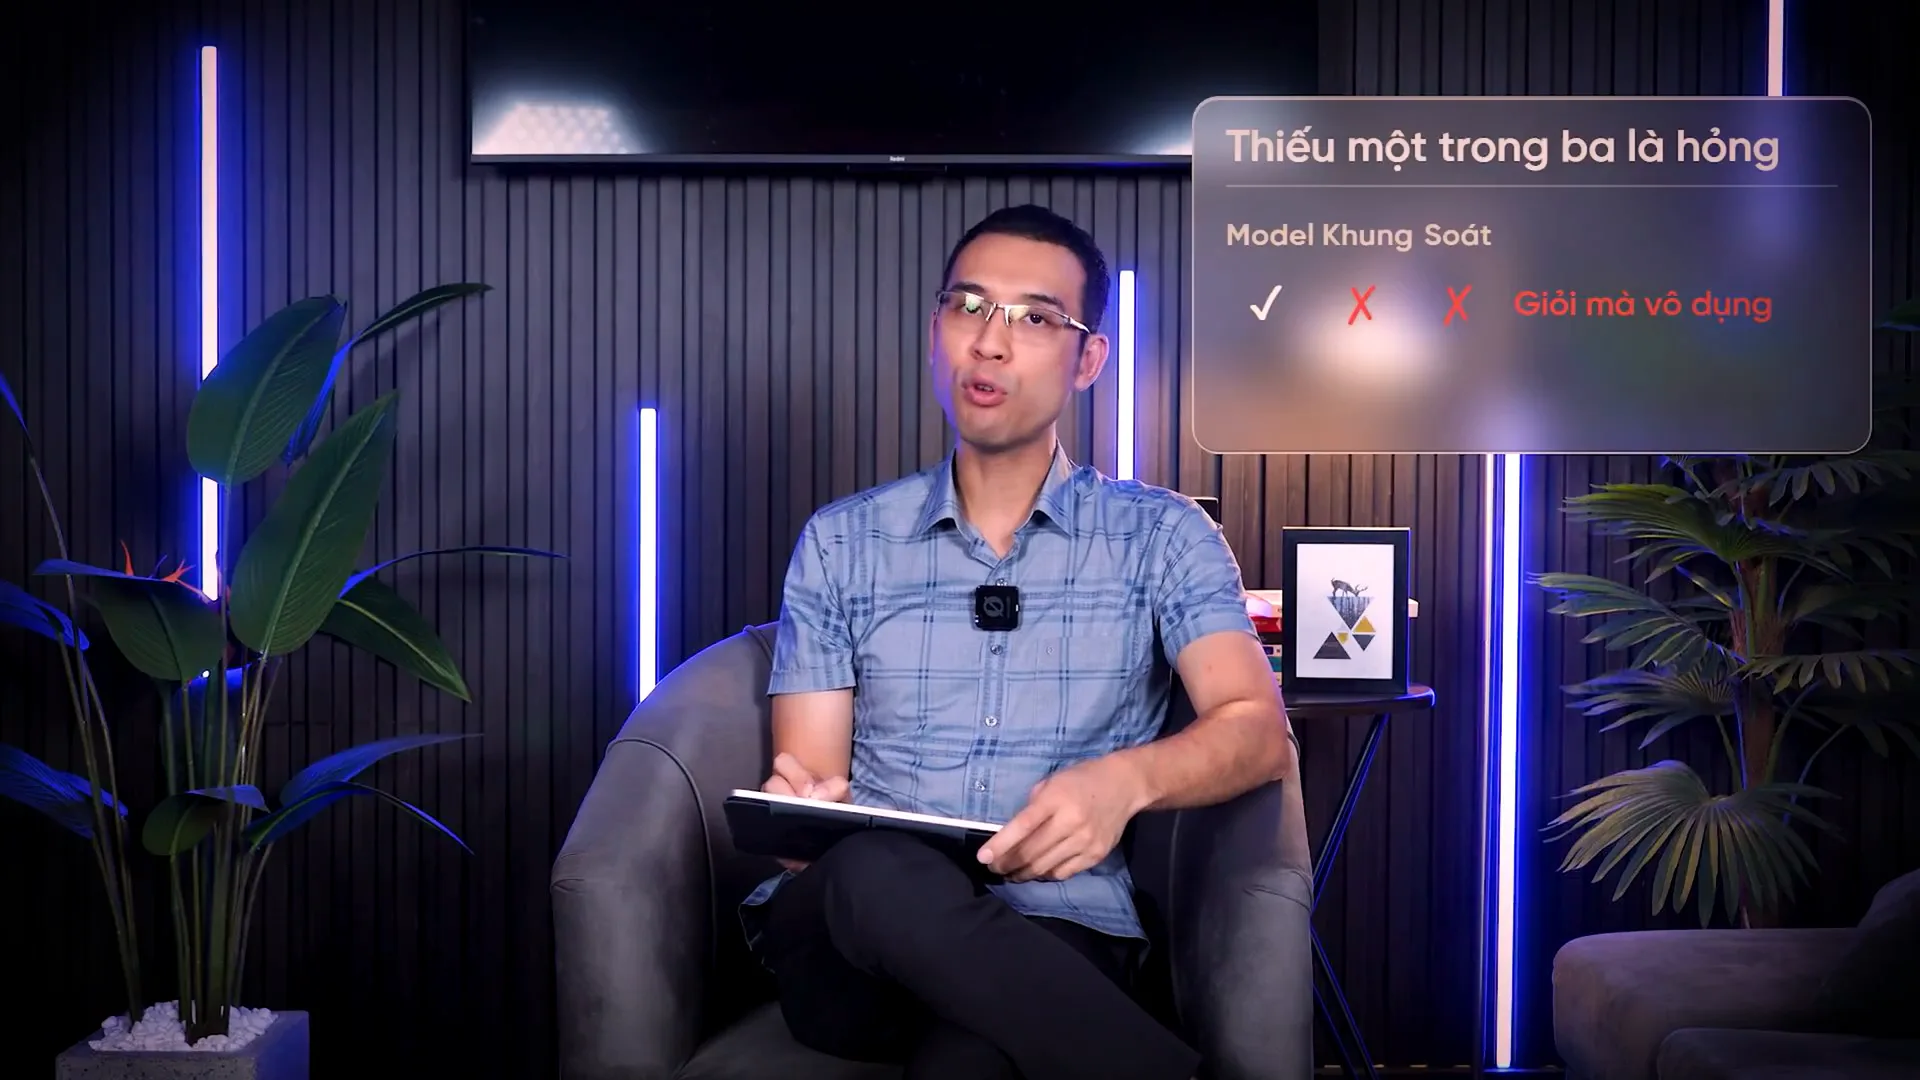
Muốn AI Agent tạo ra giá trị thật thì phải nhìn đủ ba lớp, thiếu một lớp là hỏng cả hệ thống.
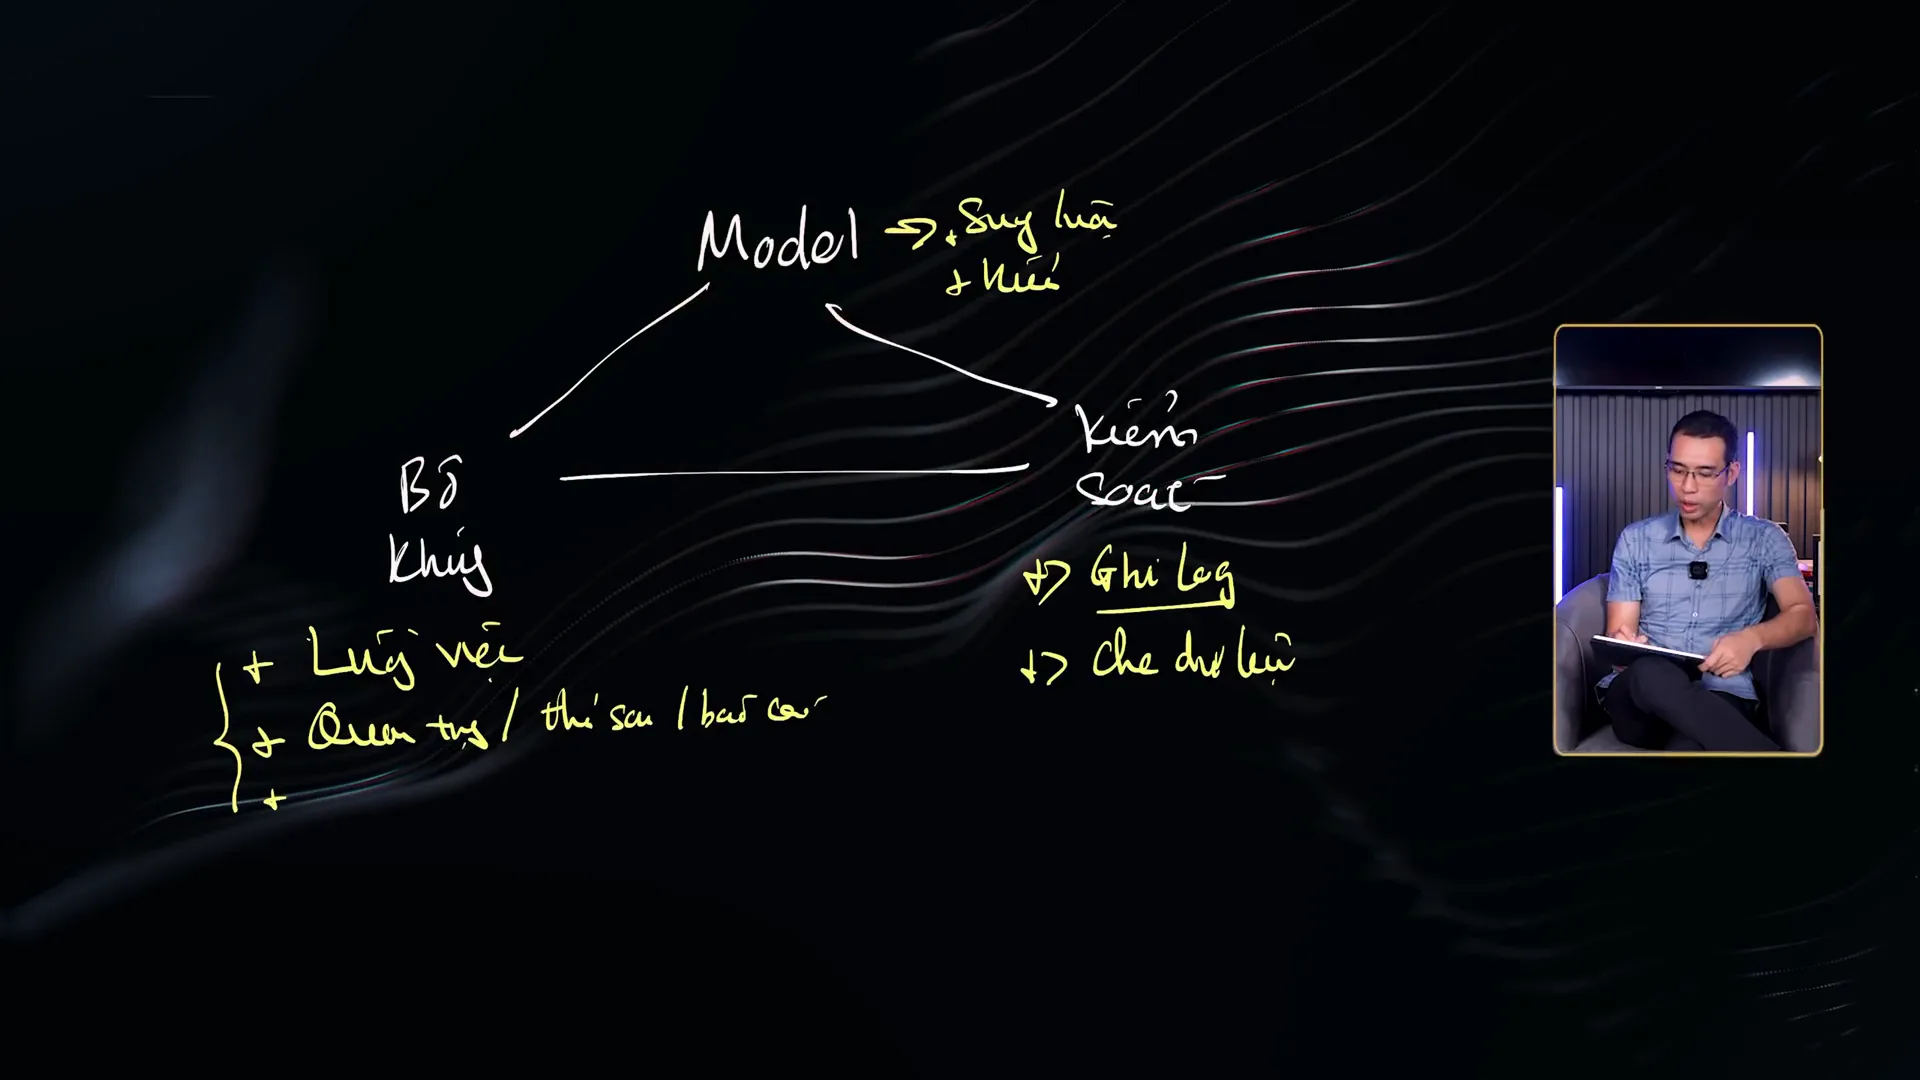
| Lớp | Nó lo việc gì | Thiếu nó thì sao |
|---|---|---|
| Model | Suy luận, hiểu đề bài | Quy trình chuẩn mấy cũng vô nghĩa vì thằng làm việc quá dốt |
| Bộ khung | Luồng việc, trạng thái, ngữ cảnh, gọi công cụ, chỗ dừng hỏi | Có người cực giỏi mà vô dụng cho công ty |
| Kiểm soát | Ghi log, sao lưu, phân quyền, che dữ liệu | Có kết quả mà không ai dám tin |
Còn một điều rất quan trọng cho anh em không làm kỹ thuật. Nếu anh em kinh doanh logistics, làm YouTube, làm du lịch, thì đừng ngồi tự dựng bộ khung riêng làm gì. Dùng thẳng bộ khung của hãng là ngon rồi. Việc của anh em là biến nó thành giá trị cho doanh nghiệp mình, không phải đi thi dựng bộ khung với OpenAI.
Nhưng doanh nghiệp vẫn phải có bộ khung của riêng mình chồng lên trên. Bản chất nó là quy tắc làm việc thôi. Giống hệt chuyện anh em tuyển một người vào công ty. Người đó giỏi mấy mà công ty không có quy trình, không có ai duyệt, không có chỗ bàn giao, thì cũng loạn. Tôi có vẽ bản đồ tổng thể cho việc này trong bài tấm bản đồ tổng thể cho đội AI Agent.
Lớp Kiểm soát gồm những gì?
Kiểm soát là cách anh em chứng minh được cái kết quả kia làm đúng quy trình, chứ không phải nó tự bịa ra. Có bốn thứ.
Ghi log. Ông làm bước một ra gì, bước hai ra gì, đầu ra từng bước là gì, ghi hết vào. Có kết quả cuối rồi thì tôi vẫn phải soi lại được đường đi.
Sao lưu trước khi sửa. File nào quan trọng mà ông định đụng vào thì sao lưu trước đã. Sai còn quay đầu được.
Cấp đúng quyền. Nó cần đọc cái gì thì cấp đúng cái đó. Đừng mở toang cả hệ thống.
Che dữ liệu nhạy cảm. Dữ liệu khách hàng thì không nhất thiết phải đưa vào. Cái nào nó thật sự cần phân tích thì mới đưa.
Đây là mẫu tôi hay dùng khi giao một đầu việc cho agent. Anh em chép về sửa lại theo nghiệp vụ của mình:
GIAO VIEC CHO AGENT

[1] Dau bai
    Viec can lam:
    Dau ra mong doi (dinh dang, do dai, noi luu):
    Tieu chi coi la DAT:

[2] Luong viec
    Buoc 1:
    Buoc 2:
    Buoc 3:

[3] Quyen han
    Duoc tu lam:
    Phai hoi y kien truoc khi lam:
    Tuyet doi khong duoc dung vao:
    So lan duoc thu sai truoc khi bao lai: 3

[4] Kiem soat, bat buoc
    Truoc khi sua bat ky file nao: sao luu ra ban .bak roi moi sua
    Sau moi buoc: ghi mot dong log gom buoc so may, lam gi, dau ra o dau
    Du lieu khach hang: che, chi giu ma so
    Cuoi viec: nop lai bang log day du cac buoc

[5] Cach bao cao
    Xong thi bao: da lam gi, con lai gi, cho nao chua chac chan
    Khong chac thi hoi, khong duoc doan roi chay tiep
Cái mẫu này không có gì cao siêu. Nó chính là thứ anh em vẫn giao cho một bạn nhân viên mới. Chỉ khác là bạn nhân viên tự hiểu ngầm được nhiều thứ, còn con AI thì phải viết ra.
Giới hạn thật của mấy con số này
Đây là phần tôi nghĩ đáng giá nhất, vì mấy chỗ này không nằm trong video và cũng không nằm trong mấy bài tóm tắt ngoài kia.
Con số 99,9% dễ bị trích sai. Nó ở mức reasoning high, không phải max. Còn 62,7% thì ở mức max. Ai đem hai số này đặt cạnh nhau mà bảo "cùng cấu hình, chỉ khác bộ khung" là nói chưa chính xác. So cùng mức max thì ra 62,7% với 98,6%, vẫn cách rất xa, nhưng phải nói cho đúng.
Dòng none có chỗ không ai giải thích. Bỏ hẳn suy luận đi thì Standard harness được 35,2%, cao hơn hẳn mức low là 17,5%. Cho suy luận ít lại tệ hơn không cho suy luận gì. ARC Prize công bố số đó nhưng không nói vì sao. Tôi cũng chưa có câu trả lời, và tôi không định bịa ra một cái.
Bộ khung chỉ quyết định mạnh ở việc nhiều lượt. Chỗ này rất đáng chú ý. Cũng chính GPT-6 Astra đó, trên ARC-AGI-1 nó được từ 86,0% tới 98,5% qua mọi mức reasoning, trên ARC-AGI-2 được từ 59,6% tới 95,0%. Hai bài đó gần như không lệch theo bộ khung, vì chúng là bài trả lời một lượt. Còn ARC-AGI-3 là bài nhiều lượt, và nó sập. Kết luận rút ra: bộ khung quan trọng với việc dài nhiều bước, chứ không quan trọng với việc hỏi đáp một lần.
Tiền của máy vẫn đắt hơn người rất nhiều. ARC Prize trả cho người tham gia thử nghiệm 115 USD một buổi 90 phút, cộng 5 USD mỗi game hoàn thành, trung bình khoảng 12,78 USD cho một game. Còn Astra tốn 18.817 USD cho cả bộ ở cấu hình 99,9%. Con số 99,9% không có nghĩa là rẻ hơn người.
Đây là số của hãng đo trên cấu hình của hãng. ARC Prize ghi rõ họ chạy 12 cấu hình harness khác nhau và công bố cái tốt nhất quan sát được. Chuyện này bình thường, ai công bố cũng chọn cấu hình có lợi cho mình. Nhưng anh em nhớ là nó không tự động lặp lại trên công việc của anh em.
Và đây là chỗ đắt nhất. Chính trang giới thiệu của OpenAI viết rằng Astra "saturates ARC-AGI-3 with a 99.9% score", không kèm một chữ nào về bộ khung. Người đọc lướt sẽ hiểu là model làm được 99,9%. Sự thật là model cộng bộ khung của hãng mới làm được 99,9%.
Vậy OpenAI có tự nhận là nhờ bộ khung không?
Có, và họ viết thẳng ra trong chính bài công bố. Chỗ này tôi thấy thú vị nhất.
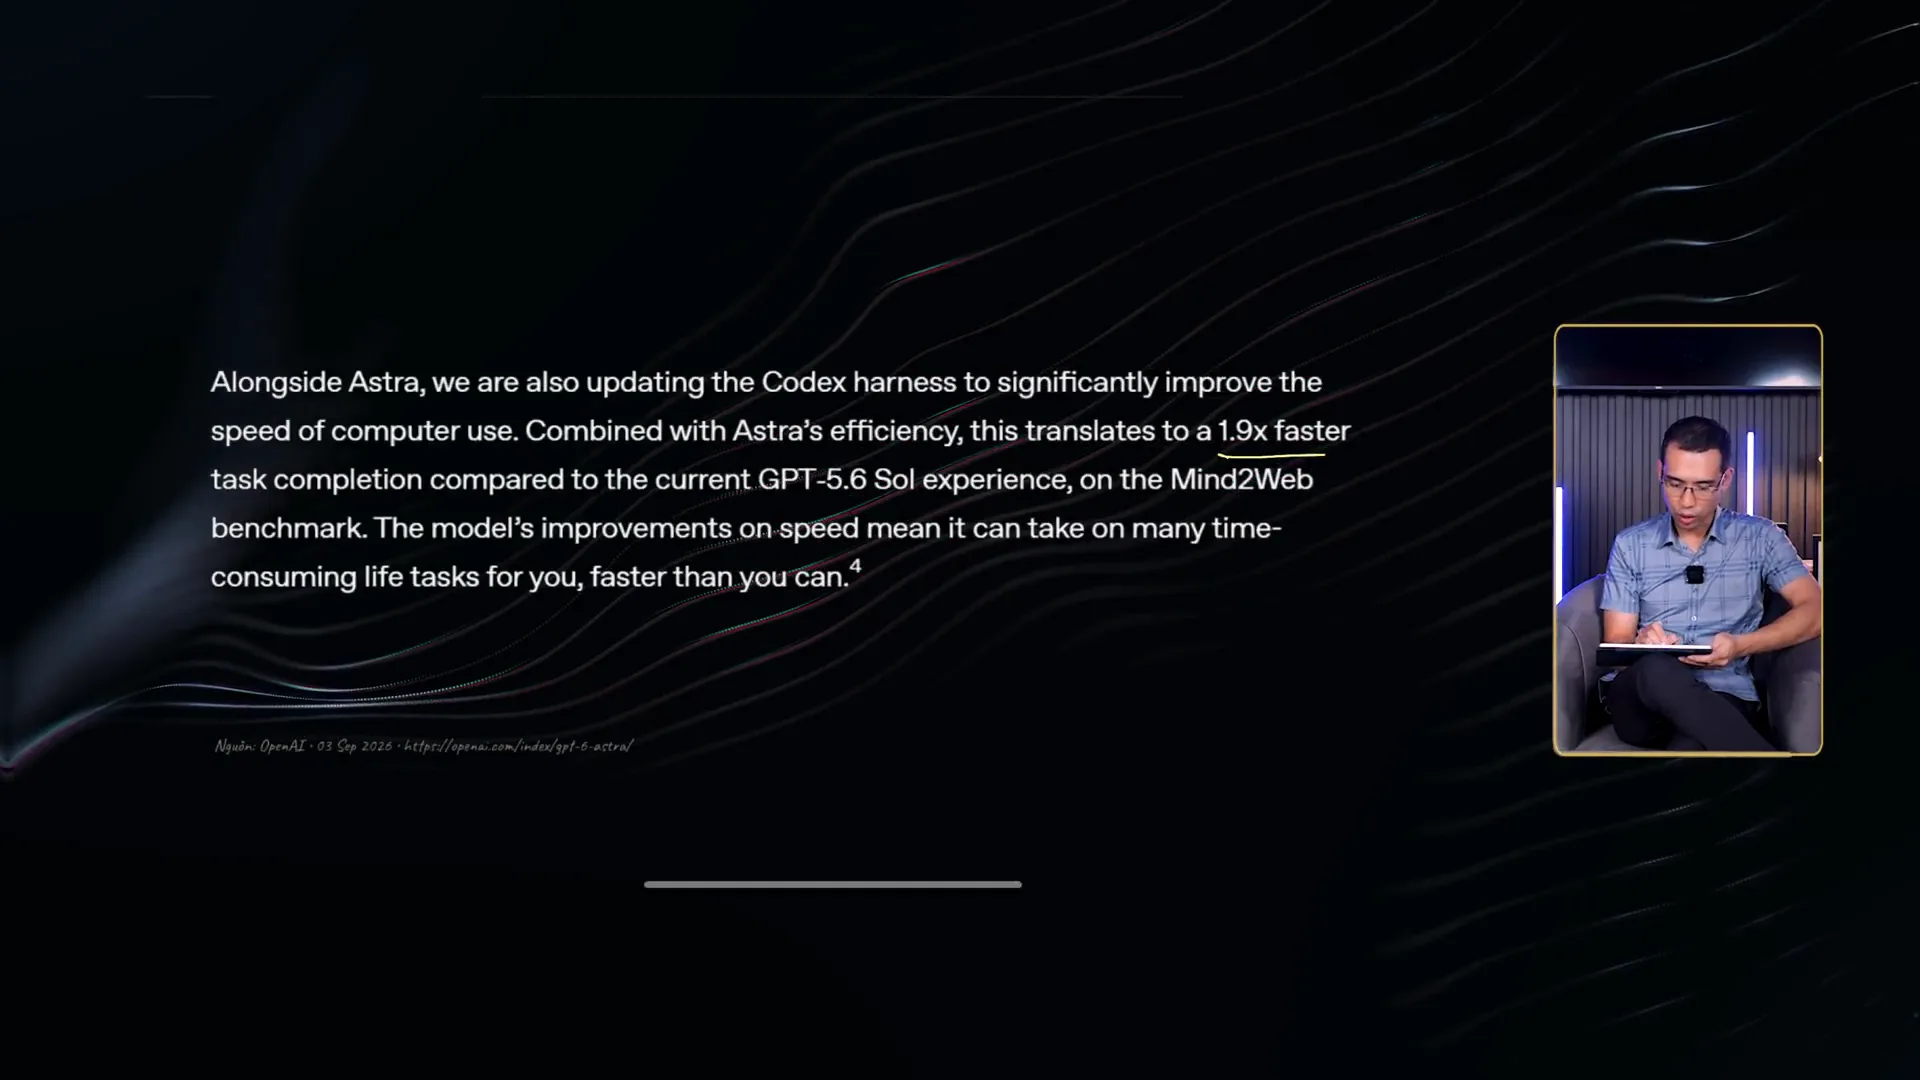
Đoạn đó nói rằng nhờ nâng cấp bộ khung Codex cộng với hiệu quả của Astra, tốc độ hoàn thành việc nhanh gấp 1,9 lần so với trải nghiệm GPT-5.6 Sol hiện tại trên phép đo Mind2Web.
Đấy. Chính hãng nói. Không phải mình tôi suy diễn. Kết quả đến từ cả hai thứ.
Bảy ngày tới anh em làm được gì?
Đừng đọc xong rồi để đấy. Có bốn việc làm được ngay, không cần đợi model nào mới.
Việc một, chọn đúng một quy trình đang chạy bằng cơm trong công ty. Chọn cái lặp đi lặp lại nhiều nhất.
Việc hai, viết quy trình đó ra thành các bước đánh số. Chưa cần đụng tới AI. Viết được ra giấy đã là nửa chặng đường.
Việc ba, đánh dấu vào đó ba thứ: bước nào agent được tự làm, bước nào phải hỏi, bước nào cấm đụng.
Việc bốn, giao thử cho agent bằng mẫu ở trên, rồi đọc log nó nộp về. Đọc log mới biết nó làm đúng hay làm bừa.
Còn đây là bảng ba câu hỏi để anh em tự soi một quy trình đang tắc nằm ở lớp nào:
SOI QUY TRINH DANG TAC NAM O LOP NAO

Cau 1 - LOP MODEL
   Model co du suc suy luan ra dap an dung khong?
   Dau hieu tac o day: doi model manh hon thi ket qua tot len ngay.
   Cach chua: nang model, hoac tang muc reasoning.

Cau 2 - LOP BO KHUNG
   No co giu duoc trang thai va di dung quy trinh khong?
   Dau hieu tac o day: lam viec ngan thi dung, viec dai thi lac de,
   quen mat buoc truoc, goi nham cong cu.
   Cach chua: chia nho luong viec, viet ro tung buoc,
   dat chot xac nhan o buoc quan trong.

Cau 3 - LOP KIEM SOAT
   Co du log, sao luu va phan quyen de kiem chung khong?
   Dau hieu tac o day: ket qua trong co ve dung nhung khong ai dam duyet.
   Cach chua: bat ghi log tung buoc, sao luu truoc khi sua,
   che du lieu nhay cam, cap dung quyen.

CACH DOC KET QUA
   Tac o cau 1 thi nang model.
   Tac o cau 2 hoac 3 thi nang model khong cuu duoc gi.
   Phan lon truong hop tac o cau 2 va cau 3.
Cứ làm đi, sai lại sửa. Không phải quá lăn tăn.
Câu hỏi hay gặp
Agent Harness là gì?
Agent Harness là toàn bộ phần chạy bao quanh model để biến nó thành một agent làm việc được. Nó lo giữ trạng thái giữa các lượt, quản ngữ cảnh và nén lại khi đầy, gọi công cụ đúng tham số, và dừng lại xin xác nhận ở bước quan trọng. Model là bộ não. Harness là căn bếp và quyển sổ ghi chú quanh bộ não đó.
Vì sao cùng một model mà hai harness lại ra kết quả lệch nhau xa thế?
Vì bộ khung tiêu chuẩn bắt model tự gánh việc ghi nhớ trạng thái, còn bộ khung của nhà cung cấp gánh hộ và còn nén ngữ cảnh khi hội thoại dài. Với bài nhiều lượt như ARC-AGI-3, quên trạng thái là hỏng cả ván. Nên điểm tụt từ 98% xuống 17,5% mà model không đổi một chữ nào.
Doanh nghiệp có nên tự dựng Agent Harness riêng không?
Phần lớn là không nên. Dùng thẳng bộ khung của hãng như Codex hay Claude là đủ ngon, vì đó là chỗ họ đổ tiền vào nhiều nhất. Thứ doanh nghiệp cần tự làm là lớp quy tắc chồng lên trên: luồng việc của mình, chỗ nào agent được tự quyết, chỗ nào phải hỏi, log ghi ra sao.
Hạ mức reasoning xuống có tiết kiệm tiền không?
Không chắc, có khi còn ngược lại. Trong bảng ARC-AGI-3, mức max hết 26.098 USD còn mức medium hết 48.090 USD, gần gấp đôi. Lý do là suy luận tốt thì giải xong trong ít nước đi hơn, ít lượt gọi hơn. Suy luận kém thì mỗi lượt rẻ nhưng số lượt phình lên. Phải đo trên chính việc của mình.
Khi nào thì nên nâng model, khi nào nên sửa quy trình?
Nếu đổi sang model mạnh hơn mà kết quả tốt lên ngay thì đúng là tắc ở lớp model. Còn nếu việc ngắn thì làm đúng mà việc dài thì lạc đề, quên bước trước, gọi nhầm công cụ, thì đó là tắc ở bộ khung, nâng model không cứu được. Còn nếu kết quả trông đúng mà không ai dám duyệt thì tắc ở lớp kiểm soát.
Con số 99,9% có nghĩa là AI đã đạt AGI chưa?
Chưa. Đó là điểm trên một phép đo cụ thể, ở một cấu hình harness cụ thể do chính nhà cung cấp dựng, trong số 12 cấu hình được thử. Con người giải được 100% số môi trường đó với chi phí khoảng 12,78 USD một game, còn Astra tốn 18.817 USD cho cả bộ. Điểm cao là thật, nhưng nó không nói lên chuyện AGI.
Đúc kết
Một model giỏi không tự động thành một hệ thống Agent đáng tin. Cùng một GPT-6 Astra, đổi bộ khung thì điểm đi từ 17,5% lên 98%, và đó là toàn bộ câu chuyện.
Nên khi anh em đưa AI vào doanh nghiệp, đừng hỏi mỗi câu "nên dùng tool gì". Hãy hỏi ba câu: model có đủ sức suy luận không, bộ khung có giữ được trạng thái và đi đúng quy trình không, và có đủ log với phân quyền để kiểm chứng không.
Model bây giờ đã rất mạnh. Bộ khung của hãng cũng đã rất tốt. Việc còn lại của anh em mình là đem nó áp vào công việc thật. Dù anh em làm logistics, làm YouTube, làm du lịch hay làm gì đi nữa, gần như đều áp dụng được rồi. Cứ thử đi, tùy anh em.
Anh em đang tắc ở lớp nào? Model, Bộ khung, hay Kiểm soát?
Nguồn tham khảo
- ARC Prize, "OpenAI's GPT-6 Astra on ARC-AGI-3", Greg Kamradt, 03/09/2026: https://arcprize.org/blog/astra
- ARC Prize, bảng kết quả đầy đủ GPT-6 Astra theo từng cấu hình harness: https://arcprize.org/results/openai-gpt-6-astra
- OpenAI, "GPT-6 Astra: A new generation of intelligence": https://openai.com/index/gpt-6-astra/
- Video gốc trên kênh Trần Quốc Huy, 13/09/2026: https://www.youtube.com/watch?v=R7xTe4cuV9s
Bài liên quan trên Wecommit: Agentic AI là gì và ba lỗ hổng của GenAI · Model mới ra mắt, doanh nghiệp đang chạy AI Agent nên làm gì · Cách tôi cho đội ngũ AI Agent vận hành cả công ty